Jev 심층 분석 - Transformer와의 차이, 병렬 결정, 그리고 속도의 원리
TypeSafe의 Jev가 무엇을 판단하는 모델인지, 자기회귀 LLM과 처리 경로가 어떻게 다른지, 병렬 질문과 확률 보정이 속도와 소프트웨어 설계에 어떤 영향을 주는지 살펴봅니다.
- GPU 연산 유닛 심화 가이드 - CUDA Core, Tensor Core, NPU
- LLM 동작 원리 - 게임 개발자를 위한 가이드
- VRAM 심화 가이드 - GPU 메모리 계층과 LLM 모델 적재
- 뇌세포로 둠을 플레이하다 - 생체 신경 컴퓨팅의 현재와 미래 심층 분석
- 비개발자를 위한 LLM 완전 가이드 - 기획자, QA, 마케터가 AI를 업무에 쓰는 법
- Claude Mythos Preview 분석 — 사이버 능력, Alignment 리스크, Project Glasswing
- 너프된 Claude — Transformer 작동원리부터 잠수함 패치·환각·토큰 폭증까지
- Jev 심층 분석 - Transformer와의 차이, 병렬 결정, 그리고 속도의 원리
- Jev는 자연어로 주어진 상태를 읽고, 개발자가 정의한 선택지·등급·참 여부에 대한 결정과 확률을 반환하는 TypeSafe의 모델입니다.
- Transformer는 신경망 구조이고 자기회귀는 출력 방식입니다. Jev의 차이를 Transformer를 쓰지 않는다는 주장으로 설명하면 안 됩니다.
- 긴 문장을 토큰마다 생성하는 경로를 피하고, 같은 상태에 대한 독립 질문을 한 요청에서 병렬 평가하는 것이 공개된 속도 설명의 핵심입니다.
- 타입에 맞는 응답과 올바른 판단은 별개입니다. 확률·confidence·임계값을 구분하고 실제 도메인에서 검증해야 합니다.


빠른 AI라고 하는데, 무엇을 빠르게 하는 걸까요?
최근 Jev를 소개하는 글에는 빠른 응답, 낮은 비용, 에이전트 자동화라는 표현이 함께 등장합니다. 그런데 Jev를 단순히 “답변을 아주 빨리 쓰는 LLM”으로 이해하면 실제 사용 방법부터 어긋납니다. Jev는 설명문을 쓰거나 코드를 작성하는 모델이 아닙니다.
이 글에서 다루는 Jev는 TypeSafe AI가 2026년 9월 15일 공개한 System One 결정 모델입니다. 같은 이름의 다른 서비스나 커뮤니티 프로젝트를 뜻하지 않습니다. TypeSafe 발표 글
관심이 커진 배경도 확인할 수 있습니다. Vercel은 9월 18일 게시물에서 Jev 제공 첫 24시간에 AI Gateway 유료 팀의 약 13%가 사용했다고 밝혔습니다. 다만 Vercel 플랫폼 내부의 관측이지, AI 시장 전체 점유율이나 장기 사용률을 뜻하지는 않습니다. Vercel 도입 현황
궁금한 부분은 네 가지입니다. Jev는 무엇을 반환하는지, Transformer와 어떤 관계인지, 왜 빠른지, 그 속도를 얻으면서 무엇을 포기했는지입니다. 공식 문서·SDK 구현·실제 통합 프로젝트·외부 평가 논문을 대조해서 설명하겠습니다. 조사 기준일은 2026년 10월 6일, 모델 기준은 jev-1.13.0입니다. 직접 유료 API를 호출해 성능을 측정한 사용기는 아닙니다.
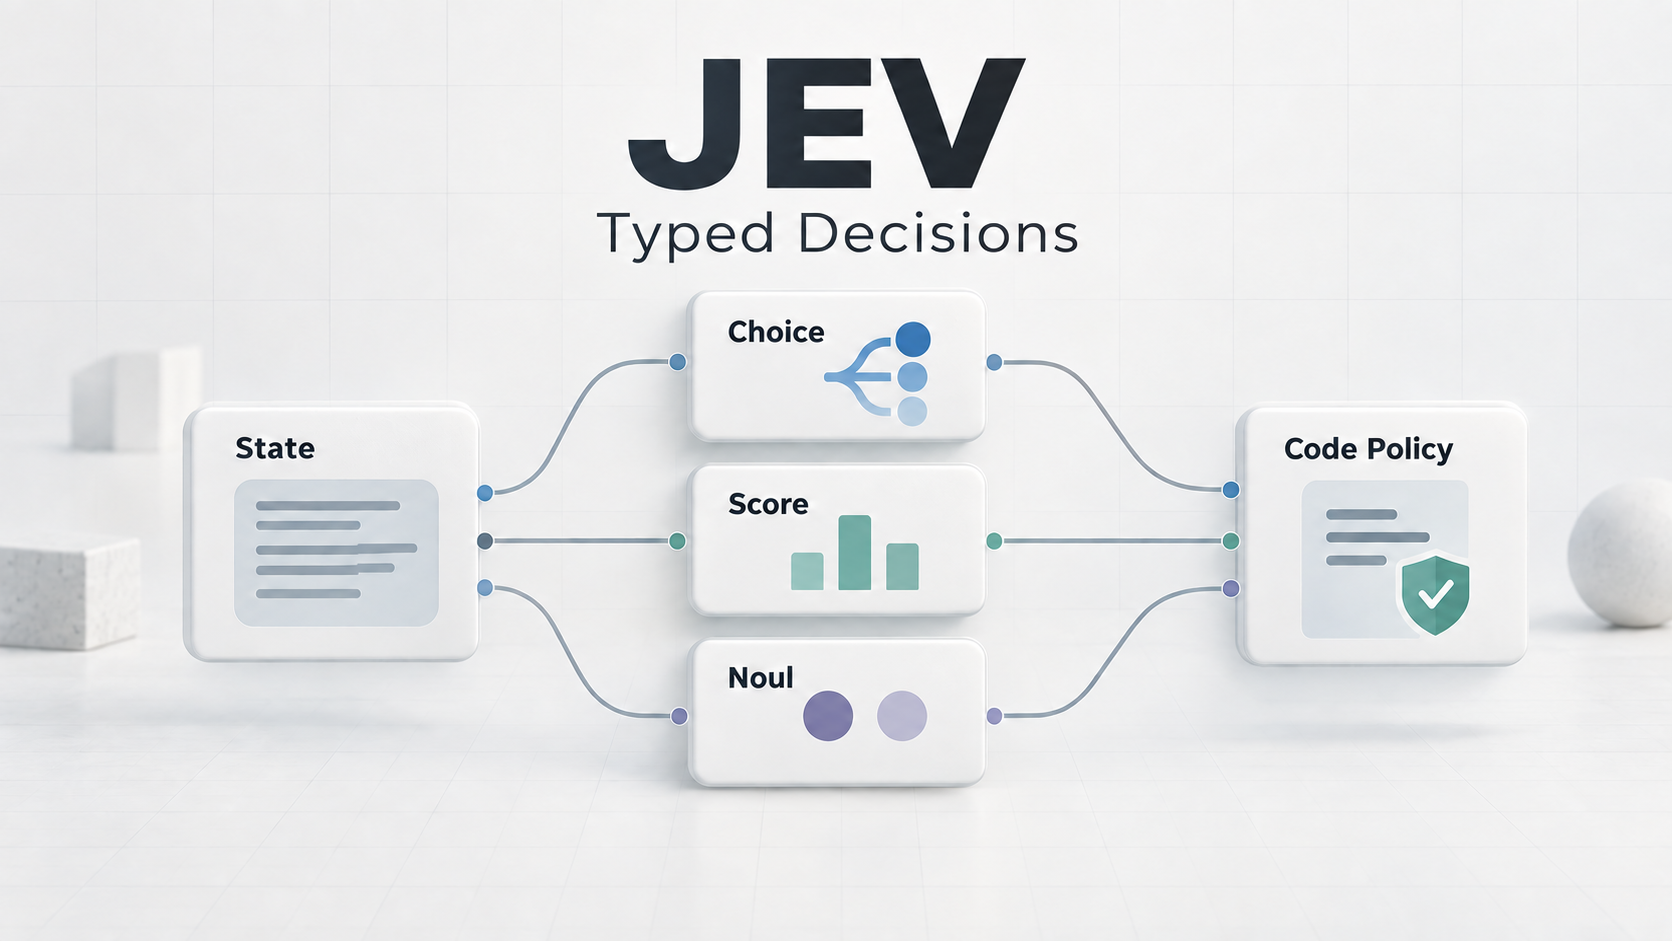
표지는 이 글을 위해 AI로 생성한 개념 이미지입니다. 하나의 상태에서 세 질문 타입을 평가하고 코드 정책이 결과를 결합하는 관계를 표현합니다. 공식 로고·제품 화면·내부 신경망 구조도나 실측 확률 그래프는 아닙니다.
1. Jev의 역할: 문장을 만드는 대신 결정을 반환합니다
입력은 상태, 출력은 제한된 답입니다
일반적인 챗봇에는 “이 문의를 어떻게 처리하면 좋을까요?”라고 질문합니다. Jev에는 처리에 필요한 상태와 판정 기준을 함께 줍니다.
예를 들어 게임 오류 신고를 다음처럼 나눕니다.
state: 신고 내용, 실행 환경, 관련 로그 등 판단에 필요한 자료questions: “담당 영역은 어디인가?”, “문제의 심각도는 어느 단계인가?”, “재현 절차가 적혀 있는가?”criteria: 선택 가능한 영역과 각 심각도 단계의 정의
세 요소 중 결정적인 것은 criteria입니다. “알아서 적절하게 처리하라”는 지시가 아니라, 애플리케이션이 받아들일 답의 공간과 의미를 먼저 정의합니다. Jev의 결과를 읽은 코드가 검토 대기열이나 담당 팀을 선택합니다. 실제 티켓 생성이나 권한 변경은 별도 실행 코드의 역할입니다.
TypeSafe는 이런 모델을 System One이라고 부릅니다. 자연어 입력을 이해하지만 자유 형식 답변·코드·판단 이유를 생성하지 않고, 타입이 정해진 결정과 확률을 반환한다는 구분입니다. 현재 Jev 입력은 텍스트이며 문자열, JSON 객체, 텍스트 배열을 지원합니다. 이미지·음성·영상은 직접 입력하지 못합니다. System One 공식 설명
System One이라는 이름은 빠르고 직관적인 판단을 뜻하는 심리학의 System 1에서 가져왔습니다. 모델 안에 사람의 직관과 동일한 사고 체계가 구현되었다는 뜻은 아닙니다.
세 가지 질문 타입
| 타입 | 맡기는 판단 | 반환값의 의미 |
|---|---|---|
| Choice | 정해진 후보 중 무엇인가? | 선택된 후보, 후보별 확률, confidence |
| Score | 설명으로 정의한 등급 중 어느 정도인가? | 등급별 확률의 가중 평균, 분포, confidence |
| Noul | 명제가 참인가? | 참일 확률인 0~1 실수 |
Noul을 Boolean으로 읽으면 중요한 정보가 사라집니다. 0.51과 0.99는 모두 true 쪽이지만, 자동 처리 정책에서 같게 취급할 이유는 없습니다. 반대로 Score 1.4는 “참일 확률 140%”가 아니라 여러 등급에 걸친 분포의 평균입니다. Choice, Score, Noul
Choice의 후보는 요청마다 바꿀 수 있습니다. 한 번 학습한 고정 라벨만 출력하는 업무 전용 분류 API와는 인터페이스가 다릅니다. 후보 이름과 설명에 의미를 넣어야 하며, 응답 매칭에 사용하는 질문 ID는 모델의 판단 입력으로 쓰이지 않습니다. is_dangerous라는 ID만 붙이고 질문 본문에서 위험의 기준을 생략하면 충분하지 않습니다. Primitives 문서
2. Transformer와 무엇이 다른가요?
먼저 비교하는 층위를 맞춰야 합니다
Transformer는 신경망 아키텍처이고, Jev는 특정 학습 목표와 결정 인터페이스를 가진 모델입니다. 따라서 “Transformer 대 Jev”를 두 개의 대체 신경망 구조처럼 비교하는 것은 정확하지 않습니다.
구분해야 하는 층위는 다음과 같습니다.
| 층위 | 묻는 질문 | 예시 |
|---|---|---|
| 신경망 구조 | 입력 사이의 정보를 어떤 연산으로 결합하는가? | Transformer의 attention과 계층 구조 |
| 추론·출력 방식 | 답을 어떤 의존 관계로 만들어 내는가? | 자기회귀 토큰 생성, 분류값 평가 |
| 학습 목표 | 어떤 결과를 잘 내도록 학습했는가? | 다음 토큰 예측, 선호도 최적화, 결정과 확률 보정 |
| 제품 인터페이스 | 호출하는 프로그램이 무엇을 받고 무엇을 반환받는가? | 대화 메시지와 텍스트, state와 typed answers |
속도에 직접 연결되는 비교는 주로 두 번째 층위입니다. 같은 Transformer 계열이라도 긴 텍스트를 순차 생성하는 경로와 정해진 후보의 판단값을 얻는 경로는 다른 작업을 수행합니다.
Transformer 원 논문은 recurrence 없이 attention을 중심으로 정보를 처리하는 구조를 제안했습니다. 그렇다고 Transformer로 만든 모든 모델이 문장을 한 토큰씩 생성하는 것은 아닙니다. BERT는 양방향 Transformer 표현에 출력 계층을 붙여 언어 추론 등의 작업을 처리한 대표적인 사례입니다. Transformer와 자기회귀 텍스트 생성은 동의어가 아닙니다. Attention Is All You Need, BERT 원 논문
Jev의 내부 신경망은 어디까지 공개되어 있나요?
TypeSafe는 사전 학습 언어 모델을 결정 모델로 학습시키는 RLCD 경로를 설명합니다. 하지만 확인한 공개 자료에는 기반 모델 이름, 파라미터 수, attention 배치, 레이어 수, 출력 헤드의 구체적인 구조가 나와 있지 않습니다. TypeSafe AI primer
따라서 다음 두 문장은 구분해야 합니다.
확인할 수 있는 설명: Jev는 일반적인 자유 텍스트의 자기회귀 생성 대신, 구조화된 결정과 확률을 반환하도록 설계되었습니다.
확인할 수 없는 설명: Jev는 Transformer를 전혀 쓰지 않으며, 특정 크기의 분류 헤드로 한 번의 행렬곱만 수행합니다.
이 글의 처리 도식과 비용식도 공개된 동작을 설명하는 개념 모델입니다. 비공개 신경망을 역으로 복원한 설계도가 아닙니다.
3. 그렇게 빠르게 처리하는 이유
3.1 긴 출력의 토큰 의존성을 피합니다
GPT류 자기회귀 언어 모델이 답변 \(y_1,\ldots,y_N\)을 생성할 때의 확률은 다음처럼 표현합니다.
\[P(y\mid x)=\prod_{t=1}^{N}P(y_t\mid x,y_{<t})\]뒤의 토큰은 앞에서 실제로 선택한 토큰에 의존합니다. 입력을 처리하는 prefill 이후에도 답변 토큰을 만드는 decode 단계가 이어지는 이유입니다. Transformer 내부의 행렬 연산을 병렬화하는 것과, 아직 결정되지 않은 미래 출력까지 모두 확정하는 것은 다른 문제입니다.
KV cache는 이미 처리한 토큰의 key와 value를 재사용해서 중복 계산을 줄입니다. 하지만 다음 토큰이 이전 출력에 의존하는 관계까지 없애지는 않습니다. “캐시가 있으니 긴 답변도 한 번에 생성된다”는 설명은 틀립니다. Hugging Face의 KV cache 설명
오류 신고를 분류하는 데 다음과 같은 답변을 끝까지 기다릴 필요는 없습니다.
1
2
3
신고 내용을 검토한 결과, 이 문제는 렌더링보다는 충돌 오류에 해당합니다.
심각도는 높으며, 사용자가 반복 과정을 적었으므로 재현 정보가 있습니다.
따라서 담당 팀에 전달하는 것이 좋겠습니다.
프로그램은 담당 영역·심각도·재현 정보만 필요합니다. Jev는 설명문 대신 정의한 타입의 답을 반환합니다. 답이나 확률을 토큰마다 이어 쓰는 경로를 피하는 점이 첫 번째 속도 요인입니다. Jev 발표의 병렬 샘플링 설명
물론 HTTP 응답에는 JSON 문자열과 숫자가 들어 있습니다. “텍스트를 생성하지 않는다”는 설명은 자유 텍스트 생성 모델처럼 답을 작성하지 않는다는 뜻이지, 네트워크 응답에 문자나 출력 바이트가 없다는 뜻은 아닙니다.
3.2 여러 질문을 같은 상태에 대해 병렬 평가합니다
오류 신고 한 건에서 담당 영역·심각도·재현 정보를 모두 판단하려고 합니다. 세 질문이 처음부터 같은 신고 내용으로 답할 수 있다면, 첫 번째 답을 기다렸다가 두 번째 질문을 보낼 이유가 없습니다.
위 도식의 차이는 질문 사이에 결과 의존성이 없다는 조건에서 성립합니다. 일반 LLM 호출도 애플리케이션에서 병렬 실행할 수 있습니다. Jev의 인터페이스는 한 state와 여러 typed question을 한 요청으로 묶어, 질문을 병렬·개별 평가하도록 제공합니다. 서로의 답을 읽으면서 순서대로 추론하는 구조가 아닙니다. 여러 질문의 평가 방식
예를 들어 “로그 서버에서 추가 기록을 조회한 뒤 원인을 판정”하는 작업은 한 번에 끝나지 않습니다. 추가 로그가 도착하기 전에는 두 번째 판정의 입력이 존재하지 않습니다. 필요한 의존성이 있는 작업까지 억지로 병렬화하면 처리 속도보다 정확성이 먼저 무너집니다.
TypeSafe가 설명하는 speculative fan-out은 실행 가능한 여러 갈래의 좁은 질문을 먼저 함께 평가하고, 나중에 코드가 필요한 결과만 사용하는 패턴입니다. 분류 결과에 따라 질문을 뒤늦게 만드는 왕복을 줄이지만, 사용하지 않은 질문도 계산·입력 비용을 가집니다. Speculative fan-out
3.3 상태의 반복 전달과 호출 왕복을 줄입니다
동일한 긴 로그를 여러 요청에 각각 넣으면 네트워크 왕복과 입력 비용이 반복됩니다. Jev 공식 문서는 한 요청의 state를 한 번 받아 모든 질문에 공유한다고 설명합니다. 질문을 추가하면 해당 질문의 입력 토큰은 늘어나지만, 같은 요청 안에서 state를 질문 수만큼 다시 청구하는 구조는 아닙니다. 모델의 context·state 처리
지연 시간을 비교할 때는 개념적으로 다음 항목을 분리하면 이해하기 쉽습니다.
\[T_{\text{AR}}\approx T_{\text{network}}+T_{\text{prefill}}(L) +\sum_{t=1}^{N}T_{\text{decode}}(L+t)+T_{\text{parse}}\] \[T_{\text{decision}}\approx T_{\text{network}}+T_{\text{state}}(L) +T_{\text{evaluate}}(Q,K)+T_{\text{serialize}}\]여기서 \(L\)은 입력 길이, \(N\)은 생성 토큰 수, \(Q\)는 질문 수, \(K\)는 후보·등급 구성에 따른 작업량을 나타냅니다. Jev 구현의 정확한 실행 시간 공식이 아니라, 생성 토큰 반복 비용과 판단 작업 비용을 구분하기 위한 분석식입니다. 대기열·재시도·도구 실행 시간은 별도로 더해야 합니다.
중요한 것은 두 번째 식에도 \(T_{\text{state}}\)와 \(T_{\text{evaluate}}\)가 남는다는 점입니다. 입력 의미를 처리하는 계산은 필요하며, 긴 state와 복잡한 질문의 비용이 사라지지 않습니다. “질문을 무한히 추가해도 지연이 일정하다”, “GPU 계산을 하지 않는다”는 결론은 나오지 않습니다.
3.4 JSON 모드만으로도 같은 효과가 나지 않나요?
자유문 대신 JSON으로 응답하게 하면 불필요한 설명을 줄일 수 있습니다. 스키마를 강제하는 constrained decoding도 유효하지 않은 구조를 제한합니다. 다만 출력 형식 제한과 토큰 순차 생성 제거는 별개의 최적화입니다. 자기회귀 모델이 JSON을 작성한다면 그 JSON도 출력 토큰입니다.
반대로 기존 언어 모델에서 짧은 라벨이나 후보별 logits만 읽어 빠르게 분류하는 구성도 가능합니다. BERT류 분류기 역시 긴 문장 생성을 필요로 하지 않습니다. Jev의 차이는 “다른 모든 모델은 느린 문장을 반드시 써야 한다”는 데 있지 않습니다. 요청마다 정의한 결정 기준, 확률을 다루는 학습 목표, 여러 질문의 병렬 인터페이스를 하나의 서비스로 제공한다는 점에 있습니다.
출력 한 토큰짜리 분류기와 장문의 reasoning 모델을 비교하면서 모델 이름만 보고 속도 우위를 일반화하면 안 됩니다. 모델 크기·출력 길이·추론 설정·네트워크 조건까지 맞춰야 어떤 비용을 줄였는지 알 수 있습니다.
4. RLCD는 무엇을 학습시키나요?
RLCD는 Reinforcement Learning for Calibrated Decisions의 약자입니다. TypeSafe는 사전 학습 언어 모델을 사람에게 보여 줄 답변이 아니라, 소프트웨어가 사용할 결정과 보정된 확률을 반환하도록 학습시키는 접근이라고 설명합니다. RLCD 공식 개요
학습 목표를 구분하면 차이가 분명해집니다. RLHF는 사람의 선호 피드백을 이용하고, RLVR은 정답 여부처럼 검증 가능한 보상을 이용합니다. RLCD가 강조하는 목표는 어떤 결정이 맞는가와 그 결정에 부여한 확률이 실제 결과를 얼마나 잘 반영하는가입니다. 세 접근을 반드시 서로 배타적인 신경망 구조로 이해할 필요는 없습니다.
예를 들어 정답을 맞혔지만 근거가 부족한 상황마다 확률 0.99를 반환하는 모델은 자동화에 위험합니다. 반대로 매번 0.50을 반환하면 검토가 필요한 사례를 구분하기 어렵습니다. 좋은 결정 인터페이스에는 결과의 구분 능력뿐 아니라 불확실성을 활용 가능한 숫자로 전달하는 능력이 필요합니다.
이를 calibration, 확률 보정이라고 부릅니다. 0.8이라고 예측한 사례들을 충분히 모았을 때 실제 사건이 약 80%에서 일어나는 관계입니다. 개별 요청 하나가 무조건 맞는다는 보장이 아니라 예측 집단에 대한 성질입니다. System One의 calibration 설명
공개 자료에는 RLCD의 구체적인 손실함수, 보상 계산식, 학습 데이터 구성과 규모가 나와 있지 않습니다. 따라서 “Brier score를 이 식으로 최소화한다”거나 “RLCD만 적용하면 확률이 항상 정확해진다”고 단정할 근거는 없습니다. 공개된 학습 목표와, 실제 제품에서 검증해야 하는 확률의 품질을 구분해야 합니다.
5. probability와 confidence를 혼동하면 안 됩니다
Choice: 선택 확률과 분포의 확신 정도
Choice의 선택지는 확률 분포를 가집니다. 개발자가 가장 높은 확률의 선택지만 읽을 수도 있고, 후보 간 분포 전체를 정책에 사용할 수도 있습니다.
공식 Choice confidence는 선택지 수 \(n>1\)에 대해 다음처럼 계산합니다.
\[c=\frac{p_{\max}-1/n}{1-1/n}\]세 후보의 분포가 (0.6, 0.3, 0.1)이라고 가정하면 다음과 같습니다.
가장 높은 선택 확률은 0.6이지만 confidence는 0.4입니다. 균등 분포보다 얼마나 한 후보에 확률이 몰렸는지를 정규화한 값이므로, confidence 0.9를 정답률 90%로 읽으면 안 됩니다. 후보 수가 바뀌면 같은 최고 확률에도 confidence가 달라집니다. Confidence 정의
확신에 찬 분포도 틀릴 수 있습니다. 모델 버전·후보 구성·도메인이 바뀌면 기존 임계값을 그대로 유지하지 말고, 자동 처리한 집단의 실제 오류율을 다시 확인해야 합니다.
Score: 등급 분포의 평균입니다
Score의 criteria는 낮은 단계에서 높은 단계로 정렬한 설명 배열입니다. 세 단계를 정의하면 인덱스는 0, 1, 2이고, 반환되는 score는 다음과 같습니다.
예를 들어 등급 확률을 (0.1, 0.4, 0.5)로 가정하면 score는 1.4입니다. 0~1로 자동 정규화된 수치가 아니며, “실제 장애 시간이 1.4시간”처럼 정확한 연속 측정값을 추정한 결과도 아닙니다. Score의 반환값
Score confidence는 최빈 단계에서 분포가 얼마나 퍼져 있는지를 요약합니다. Choice의 공식을 그대로 적용하지 않습니다. 단계 설명도 “앞 단계보다 심각함”처럼 이웃 설명을 참조하기보다, 각 단계가 어떤 상태를 뜻하는지 독립적으로 작성해야 합니다.
Noul: 확률을 정책으로 바꾸는 책임은 코드에 있습니다
Noul의 .noul은 명제가 참일 확률입니다. 별도의 .confidence 필드는 없습니다. 예를 들어 “재현 절차가 충분한가?”라는 질문에 받은 확률을 이용해 자동 전달 / 추가 정보 요청 / 사람 검토라는 세 정책으로 나눌 수 있습니다. Noul 공식 문서
하지만 경계를 0.5로 할지 0.9로 할지는 모델이 대신 정해 주지 않습니다. 잘못 자동 처리한 비용과 사람이 검토한 비용이 다르기 때문입니다. 특히 결제·계정 초기화·파일 삭제 같은 동작의 권한과 명시적 승인은 모델의 확률 밖에서 검사해야 합니다. 모델이 “안전할 확률이 높다”고 답하는 것과 사용자가 그 실행을 허용한 것은 다른 사실입니다.
6. SDK로 보면 역할 분담이 더 명확합니다
게임 오류 신고를 세 질문으로 나누는 예제
공식 Python 패키지는 typesafe-sdk, import 이름은 typesafe_sdk입니다. 아래는 Python SDK 0.7.2의 호출 형태에 맞춰 작성한 예제입니다. TYPESAFE_API_KEY 환경변수에 키를 설정해야 하며, 실행하면 외부 API 호출과 비용이 발생합니다. 글을 작성하면서 실제 호출하거나 결과를 얻지는 않았습니다. 공식 Python SDK
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

state = {
  "report": (
    "전투가 끝나고 결과 화면으로 넘어갈 때 앱이 종료됩니다. "
    "같은 맵에서 전투를 다시 끝내면 똑같이 발생합니다. "
    "재접속하면 전투 기록은 남아 있습니다."
  ),
  "environment": {"platform": "Android", "build": "test-build"},
}

with TypeSafeClient() as client:
  result = client.system_one(
    model="jev-1.13.0",
    state=state,
    questions={
      "area": Choice(
        instructions="report에서 설명한 주된 문제 유형은 무엇인가?",
        criteria={
          "crash": "앱이 비정상적으로 종료되거나 응답하지 않는다.",
          "rendering": "앱은 동작하지만 화면의 표시나 시각 효과가 잘못된다.",
          "network": "서버 연결이나 통신 오류가 주된 문제이다.",
          "other": "위 유형에 해당하지 않거나 분류에 필요한 정보가 부족하다.",
        },
      ),
      "severity": Score(
        instructions="report에 적힌 증상을 플레이 방해 정도로 평가하라.",
        criteria=[
          "표시상의 문제이며 플레이 진행을 막지 않는다.",
          "일부 기능을 방해하지만 앱을 종료하지 않고 진행할 수 있다.",
          "앱 종료 또는 진행 불가로 플레이를 중단시킨다.",
        ],
      ),
      "has_steps": Noul(
        instructions="report에 문제가 발생하는 행동 순서가 적혀 있는가?",
        criteria={
          "true": "문제 발생 전 사용자가 수행한 행동이나 전환 순서를 설명한다.",
          "false": "증상만 설명하고 발생 전 행동 순서는 설명하지 않는다.",
        },
      ),
    },
  )

area = result.choices["area"]
severity = result.scores["severity"]
steps_probability = result.nouls["has_steps"].noul

# 설명용 임계값입니다. 실제 한국어 신고 자료로 평가한 뒤 조정해야 합니다.
if area.choice == "other" or area.confidence < 0.8:
  queue = "human_review"
elif steps_probability < 0.8:
  queue = "request_reproduction_details"
else:
  queue = f"qa_{area.choice}"

print(result.model, queue, severity.score)
예제에서 Jev가 하는 일은 같은 신고 내용에 대한 세 판단까지입니다. queue는 코드가 선택한 문자열이지, 티켓을 생성했다는 실행 결과가 아닙니다. 신고 내용과 정책 경계는 예제를 위해 작성했으며, 실제 분류 확률·응답 시간·출력값을 지어내지 않았습니다.
has_steps도 “절차가 적혀 있는가”만 묻습니다. 절차를 실제 기기에서 실행해 재현에 성공했는지까지 보증하지 않습니다. 더 강한 결론이 필요하면 로그 확인이나 테스트 실행이라는 관측 단계를 추가해야 합니다.
호출 인터페이스에서 주의할 부분
Choice의 criteria는 후보 이름을 키로 하는 객체이고, Score는 순서가 있는 설명 배열입니다. Python에서는 응답을 result.choices, result.scores, result.nouls로 구분해서 읽을 수 있습니다. 응답 JSON을 받아 eval()로 코드처럼 실행하는 처리는 필요하지 않습니다. Python 질문 타입, Python 응답 구현
직접 HTTP로 호출할 때는 POST https://api.typesafe.ai/v1/systemone에 state, model, questions를 보냅니다. JavaScript의 공식 SDK는 @typesafe-ai/sdk이고 메서드 이름은 systemOne입니다. Python의 system_one과 이름이 다릅니다. HTTP API, 공식 JavaScript SDK
Vercel AI Gateway를 사용하는 경우도 일반 텍스트 생성 API와 구분해야 합니다. 확인일 기준 TypeScript AI SDK 7.0.128 이상은 experimental_decide와 gateway.decisionModel('typesafe-ai/jev')를 사용합니다. 이전 이름인 experimental_evaluate와 혼동하기 쉽고, HTTP 경로는 아직 /v1/evaluate입니다. API 이름이 바뀌는 초기 제품이므로 오래된 예제를 그대로 복사하기보다 사용 중인 버전의 공식 문서를 확인해야 합니다. Gateway Decision API
7. 실제로 어디에 들어가나요?
Jev가 효과를 내는 자리는 대개 생성·도구 실행 사이의 좁은 판단 지점입니다. 공개 프로젝트를 보면 모델 자체의 역할과 주변 코드의 역할을 구분할 수 있습니다.
모델 라우팅과 도구 실행 전 평가
LangChain의 ModelRouterMiddleware는 사용자 메시지를 미리 정의한 기준으로 분류한 뒤 사용할 생성 모델을 선택합니다. Jev가 답변을 작성하는 것이 아니라 어느 모델에 답변을 맡길지 고릅니다. 같은 통합의 AutoModeMiddleware는 등록된 도구 호출을 평가하고, 위험하다고 판단하면 실행 대신 오류 메시지를 반환합니다. 사람의 승인을 받는 절차 자체는 별도로 구현해야 합니다. LangChain TypeSafe 통합
실행 경계는 다음처럼 나누는 편이 명확합니다.
위 도식에서 권한 검사가 빠지면 높은 모델 확률이 실행 허가처럼 취급됩니다. Jev는 의미 판정을 돕는 구성 요소이고, 권한 시스템은 아닙니다. 입력 데이터에 숨겨진 악의적인 지시도 모델 판단을 흔들 수 있으므로, typed output만으로 안전성이 완성되지는 않습니다.
브라우저 조작: 행동 후보를 고르고, 실행기가 확인합니다
browser-use/jev-ultrafast는 관측한 DOM 요소에 번호를 붙이고, 한 요청에 동작 종류와 동작별 대상 질문을 보냅니다. 클릭이 선택되면 클릭 대상의 답을 사용합니다. 텍스트 입력이 필요한 경우에는 별도의 작은 LLM이 입력 문자열을 만듭니다. Jev가 스크린샷을 보고 좌표나 JavaScript를 자유 생성하는 구성은 아닙니다. 프로젝트 README, 요청 구성 원본
공개 성능 문서는 한 Google Flights 작업에서 각 버전을 세 번씩 비교했다고 설명합니다. 빠른 데모의 존재는 확인할 수 있지만, 모든 사이트의 조작을 같은 속도와 성공률로 처리한다는 증거는 아닙니다. 관측한 노드가 아직 유효한지, 클릭 가능한지도 주변 실행 코드에서 검사합니다. 측정 범위와 제약
컨텍스트 압축: 새 요약문 작성이 아니라 보존 여부 판단
커뮤니티 플러그인 fast-jev-compaction은 도구 호출과 결과를 묶고, 각각을 남길 필요가 있는지 Noul로 평가합니다. 코드가 원문 보존·결과 축약·제거를 선택합니다. Jev가 새로운 요약문을 쓰는 방식은 아닙니다. 플러그인 원본, 압축 분기 구현
주의할 점은 판단용 state에 도구 결과의 전체 본문이 들어가지 않는다는 사실입니다. 결과 길이·성공 여부 같은 정보와 대화·호출 내용을 이용합니다. 따라서 “전체 내용을 읽고 중요한 사실만 완벽하게 보존한다”고 소개하면 틀립니다. 남긴 원문을 바꾸지 않는 것과 전체 압축이 무손실이라는 것은 다릅니다. state 구성 원본
게임에서는 프레임 로직보다 상위 의사결정에 가깝습니다
TypeSafe의 Doom 예시는 이미지가 아닌 구조화된 텍스트 게임 상태를 사용합니다. 규칙 기반 봇보다 잘 플레이한다는 주장도 아닙니다. Doom 예시의 조건
게임 개발에 적용한다면 NPC의 상위 행동 후보 평가나 운영 신고 분류가 먼저 떠오릅니다. 다만 이것은 적용 가능성에 대한 설계 해석이지 이 블로그의 게임 프로젝트에 Jev를 이미 붙였다는 사용기가 아닙니다. 충돌 처리·쿨다운·피해 계산·프레임별 이동처럼 코드가 정확하게 계산할 수 있는 작업을 외부 모델로 옮길 이유는 없습니다. 수백 ms 응답도 60fps의 한 프레임 예산인 약 16.7ms와는 다른 시간 규모입니다.
8. 벤치마크: 무엇이 측정되었고, 무엇은 아직 모릅니까?
회사의 193.6배·444.6배 수치
TypeSafe의 출시 글은 193.6배 빠르고 444.6배 저렴하다는 수치를 제시합니다. 회사가 구성한 네 가지 workflow 평가의 결과이며 모든 작업에 대한 보장이나 SLA는 아닙니다. 다른 LLM도 wrapper를 통해 확률을 출력하도록 연결합니다. 기준 응답은 인간 정답 라벨 대신 GPT-6 Astra와 Claude Fable 5.1의 평균입니다. 회사는 평가 편향과 실제 환경에서 이득이 줄어들 가능성도 설명합니다. 회사 평가 조건, 공개 workflow 평가
판단 한 개의 라벨만 필요한 서비스와 여러 후보의 확률을 생성하는 비교 서비스는 출력량이 다릅니다. 따라서 숫자를 인용할 때는 동일한 최종 업무를 어떤 호출·출력 방식으로 수행했는지까지 읽어야 합니다.
같은 발표의 “환각 0”은 스키마 일치 보장으로 산정한 값이지 의미 판정의 무오류 실측값이 아닙니다. crash라는 유효한 라벨로 네트워크 문제를 잘못 분류하는 오류는 여전히 가능합니다. 타입 보장과 그래프 산정 조건
외부 평가에서 확인한 낮은 지연과 비용
9월 29일 공개된 Evaluating and Benchmarking the System One Model Jev는 jev-1.13.0을 37개 데이터셋에서 평가했습니다. 본평가 346,009개 요청의 비용은 9.15달러, 평균 client-side 지연은 0.36초였습니다. 동시 요청 32개와 네트워크 시간을 포함한 측정입니다. 비교한 오픈웨이트 모델은 reasoning 없이 후보 logits를 읽는 방식이었습니다. 논문 §4.7·§5
이 측정은 짧은 결정 작업에서 낮은 비용과 지연이 나온다는 근거입니다. 회사의 193.6배 수치를 같은 조건으로 독립 재현했다는 뜻은 아닙니다. GPU 내부 추론 시간, 한국에서 호출했을 때의 지연, 장기 운영의 P95를 대신하는 값도 아닙니다.
확률은 작업에 따라 다르게 검증해야 합니다
같은 논문에서 Choice의 통합 ECE는 0.028이지만, multi-label Noul의 ECE는 0.168이었습니다. ECE는 예측 확률과 해당 사건의 실제 발생 빈도의 차이를 구간별로 요약하는 지표입니다. Choice는 선택 후보가 정답인 빈도, Noul은 실제 yes 발생 빈도와 비교합니다. 서로 다른 작업·집계 조건의 숫자를 하나의 “신뢰도”로 합치면 안 됩니다. UNFAIR-ToS의 micro-F1도 고정 0.5 임계값에서는 0.499, 학습 자료로 조정한 임계값에서는 0.748이었습니다. 논문 §4.3
9월 28일 공개된 별도 Sys1Cal-v1 연구는 알려진 정답 확률을 가진 92개 합성 문제를 365개 형태로 표현했습니다. 같은 명제라도 Choice·Noul·Score와 문장 표현에 따라 확률이 일관되지 않을 수 있다고 보고합니다. 논문의 0.978 수치는 일반 정답률 97.8%가 아니라, 불확실성을 포함한 구간과 정답 확률의 호환성 지표입니다. Sys1Cal-v1 논문
두 외부 연구는 아직 preprint이고 평가 목적도 다릅니다. 첫 연구의 일반 분류 성능과 두 번째 연구의 합성 확률 문제를 단순한 찬반 결과로 묶을 수 없습니다. 실무에서 필요한 결론은 “확률이 나오므로 곧바로 안전하게 실행”이 아니라, 내 작업에서 확률·임계값·검토 정책을 함께 평가해야 한다는 것입니다.
9. Jev 1.13에서 남겨 두어야 할 경계
제품 자체가 공개한 약점
TypeSafe의 10월 2일 검토 문서는 다음 약점을 명시합니다.
- 수학·개수 세기·정확한 숫자 비교와 날짜 비교
- 이중 부정이나 여러 단계를 거치는 간접 판단
- 판단과 무관한 내용이 많이 들어간 긴 state
- 악의적인 지시가 포함된 입력, 모순된 instructions와 criteria
- Choice 후보의 순서에 따른 응답 변화
- 자유 텍스트 생성 작업
가장 직접적인 설계 원칙은 의미 판단만 모델에 맡기고 정확한 연산은 코드에 남기는 것입니다. “위험한 요청처럼 보이는가?”와 “거래 금액이 한도를 초과했는가?”를 한 모델 질문으로 묶지 않습니다. 후자는 이미 확보한 숫자로 비교할 수 있습니다. 질문이 독립적으로 평가된다는 특성도 무관한 긴 state에 면역이라는 뜻은 아닙니다. Jev 1.13의 공식 known issues
현재 모델의 입력과 요금 제한
| 항목 | 2026-10-06 공식 문서 기준 |
|---|---|
| 버전 | jev-1.13.0; jev-latest와 jev-preview도 현재 같은 버전 |
| 입력 | 텍스트만 지원 |
| 요청 context | state와 모든 질문 합계 64k tokens |
| 개별 질문 context | state와 가장 긴 질문 합계 32k tokens |
| 요금 | 입력 100만 토큰당 $0.042, 출력 무료 |
| 명시된 처리 한도 | 초당 100K tokens / 80 requests; 변경 가능 |
출력 무료는 요금 정책입니다. 출력 계산이 물리적으로 무료라는 의미는 아닙니다. 또한 context 최대치에 들어간다는 사실이 최대 길이에서의 정확성을 보장하지 않습니다. 영어가 주 학습 언어이고 가장 정확하다고 명시되어 있으므로 한국어 운영 자료로 별도 검증해야 합니다. 현재 모델 카드
jev-latest는 새 모델이 나오면 가리키는 버전이 바뀝니다. 임계값을 평가한 제품에서는 버전 ID를 고정하고 응답의 모델 버전을 기록하는 편이 낫습니다. 요금·한도·SDK API도 시간에 따라 바뀌므로, 글의 숫자를 영구적인 사양으로 읽지 않아야 합니다.
도입 전에는 모델만이 아니라 전체 경로를 측정합니다
실제 서비스의 지연은 모델 응답 시간에 상태 수집, 네트워크, 재시도, 추가 정보 조회, fallback 시간이 더해집니다. SDK의 backoff와 재시도는 일부 요청의 지연을 늘리므로, 성공한 단일 호출의 평균뿐 아니라 전체 경로의 P95도 따로 측정해야 합니다. 데이터 전송의 범위도 중요합니다. 고객 데이터를 학습하지 않는다는 설명과 저장·로그를 전혀 남기지 않는다는 보장은 같지 않습니다. 계약과 보존 정책을 따로 확인해야 합니다. API 오류·재시도, 모델의 데이터 처리 설명
최소한 다음 항목을 자체 평가에 포함하는 편이 좋습니다.
- 실제 한국어 사례와 경계 사례에 대한 분류 오류·확률 보정
- 임계값별 자동 처리 비율과 자동 처리된 사례의 오류율
- 후보 순서를 바꾼 입력, 부정문, 입력 안의 악의적인 지시
- 전체 workflow의 P50·P95와 재시도·fallback을 포함한 비용
- timeout·rate limit·판정 충돌에서의 보수적인 검토 경로
여기서 두 번째 항목이 자동화 수준을 결정합니다. 임계값을 높여 오류를 줄였더라도 대부분의 사례가 사람에게 넘어간다면 업무 효과는 달라집니다. 오류율과 자동 처리 비율을 함께 봐야 빠른 모델이 제품 전체를 얼마나 빠르게 만들었는지 판단할 수 있습니다.
마무리: 생성과 결정을 분리해서 봅니다
Jev를 이해하는 데 가장 중요한 비교 대상은 Transformer 자체보다 문장 생성기로 작은 판단을 수행하던 처리 경로입니다. 자연어로 정의한 기준을 읽되 출력 공간을 결정 타입으로 좁히고, 독립 질문을 묶어서 코드가 결합하도록 제공하는 모델입니다.
답변 작성·새 코드 생성·긴 추론이 필요한 곳에는 생성 모델이 남습니다. 라우팅·분류·평가처럼 좁은 판단이 반복되는 곳에는 결정 모델을 검토할 수 있습니다. 어느 모델이 더 똑똑한가만 묻기보다, 프로그램이 필요한 결과가 문장인지 결정인지부터 정하는 것이 Jev를 제대로 평가하는 출발점입니다.
조사 범위와 주요 원문
공식 문서의 개념·질문 타입·confidence·모델 카드·known issues, Python·JavaScript SDK와 adapter, Gateway·LangChain 통합, 브라우저·압축 프로젝트 원본, 두 외부 평가 논문을 조사했습니다. 내부 가중치나 학습 코드를 확보한 것은 아니며, 예제 프로젝트를 직접 실행하거나 유료 API 벤치마크를 수행하지는 않았습니다.
| 확인할 내용 | 1차 자료 |
|---|---|
| 출시 목적·회사 성능 주장 | TypeSafe 출시 글 |
| 모델 개념·학습 목표 | System One, RLCD 개요 |
| 타입·확률·사양 | Primitives, Confidence, Models |
| SDK·비교용 adapter | Python SDK, JavaScript SDK, System One adapter |
| 외부 업무 평가 | 37개 데이터셋 평가 논문 |
| 외부 확률 의미 평가 | Sys1Cal-v1 논문 |
비교용 adapter는 다른 LLM을 같은 질문·응답 인터페이스에 연결하는 도구입니다. Jev의 가중치를 제공하거나 RLCD와 확률 보정을 재현하는 공개 모델 구현은 아닙니다. 같은 API 모양과 같은 모델 동작을 혼동하지 않아야 합니다.