Jev徹底分析 - Transformerとの違い、並列判断、速度の仕組み
TypeSafeのJevが何を判断するモデルなのか、自己回帰LLMと処理経路がどう異なるのか、並列質問と確率の較正が速度とソフトウェア設計にどう影響するのかを解説します。
- GPU演算ユニット深掘りガイド:CUDAコア、Tensorコア、NPU
- LLMの動作原理 - ゲーム開発者向けガイド
- VRAM深掘りガイド:GPUメモリ階層とLLMモデルのロード
- 脳細胞でDOOMをプレイする — 生体神経コンピューティングの現在と未来の徹底分析
- 非開発者のためのLLM完全ガイド — プランナー、QA、マーケターがAIを業務に活用する方法
- Claude Mythos Preview 分析 — サイバー能力、Alignmentリスク、Project Glasswing
- ナーフされたClaude — Transformerの動作原理から潜水艦パッチ・ハルシネーション・トークン爆増まで
- Jev徹底分析 - Transformerとの違い、並列判断、速度の仕組み
- Jevは自然言語で与えられた状態を読み、開発者が定義した選択肢・段階・真偽についての判断と確率を返すTypeSafeのモデルです。
- Transformerはニューラルネットワークの構造で、自己回帰は出力方式です。Jevの違いを、Transformerを使わないという主張で説明してはいけません。
- 長い文章をトークンごとに生成する経路を避け、同じ状態に対する独立した質問を1回のリクエストで並列評価することが、公開されている速度の説明の中心です。
- 型に合った応答と正しい判断は別のものです。確率・confidence・しきい値を区別し、実際のドメインで検証する必要があります。


高速なAIといいますが、何を高速に処理するのでしょうか?
最近のJev紹介記事には、高速な応答、低コスト、エージェントの自動化といった表現が並びます。しかし、Jevを単に「回答をとても速く書くLLM」と理解すると、使い方からずれてしまいます。Jevは説明文やコードを書くモデルではありません。
この記事で扱うJevは、TypeSafe AIが2026年9月15日に公開したSystem Oneの判断モデルです。同名の別のサービスやコミュニティプロジェクトを指すものではありません。TypeSafeの発表記事
注目が集まった背景も確認できます。Vercelは9月18日の記事で、Jevの提供開始から最初の24時間にAI Gatewayの有料チームの約13%が利用したと発表しました。ただし、これはVercelプラットフォーム内の観測であり、AI市場全体のシェアや長期的な利用率を意味しません。Vercelの導入状況
知りたいのは4点です。Jevは何を返すのか、Transformerとどのような関係にあるのか、なぜ速いのか、その速度を得るために何を手放しているのかです。公式ドキュメント・SDK実装・実際の統合プロジェクト・外部の評価論文を照合して説明します。調査基準日は2026年10月6日、対象モデルはjev-1.13.0です。有料APIを直接呼び出して性能を測定した使用記ではありません。
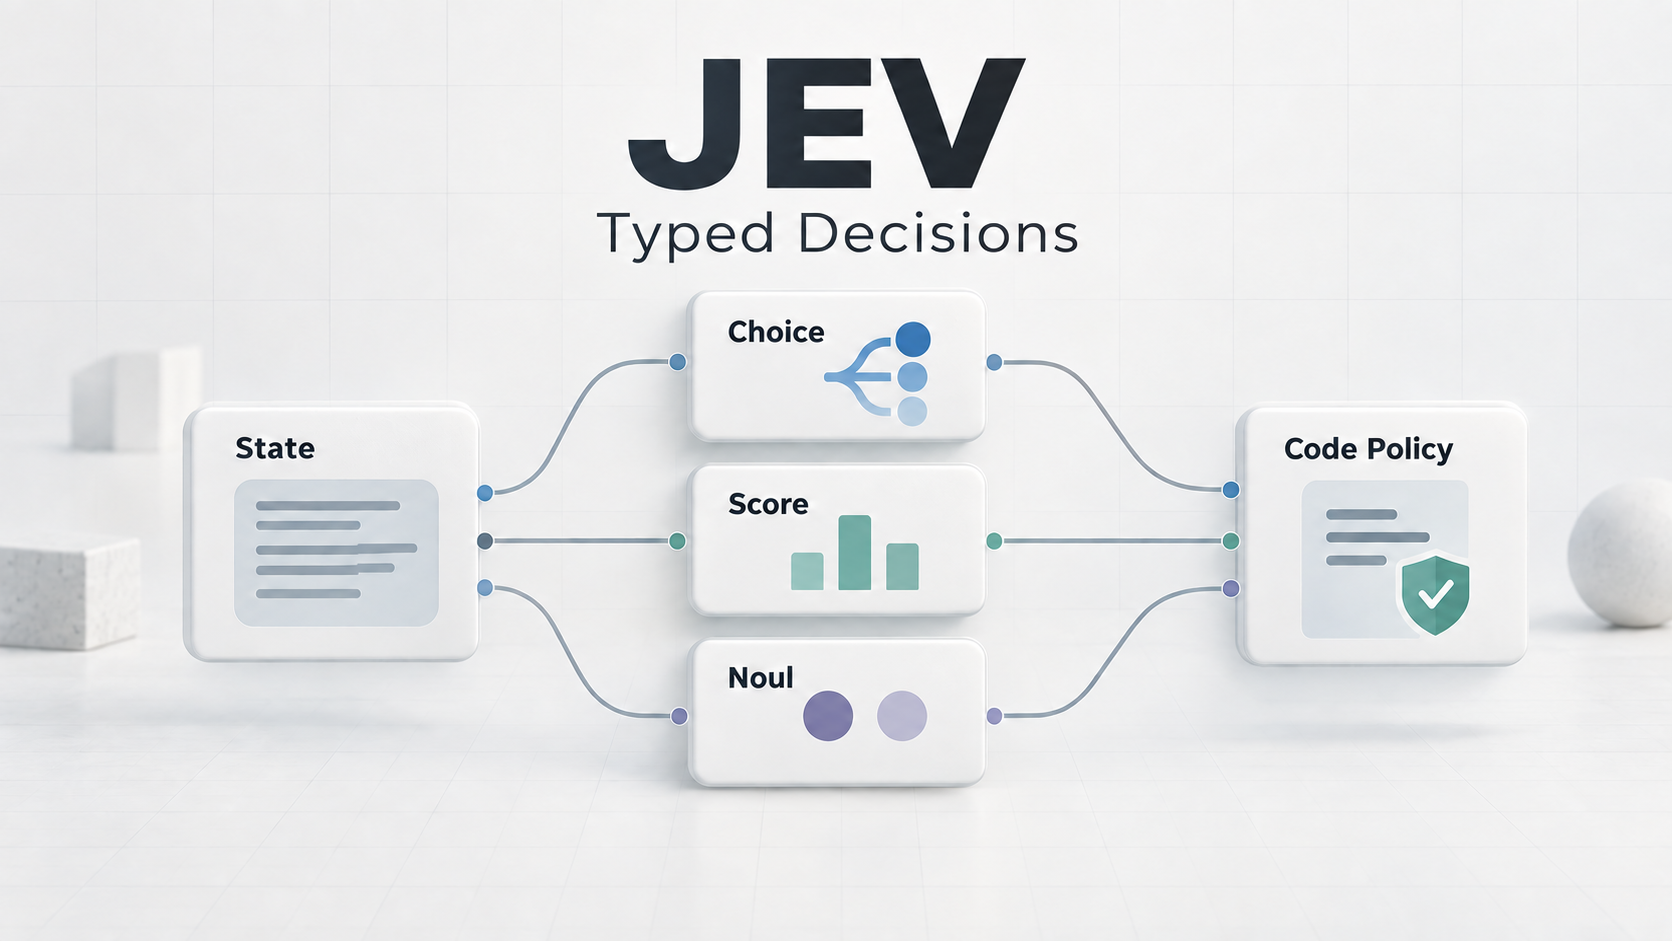
表紙は、この記事のためにAIで生成した概念画像です。1つの状態に対して3種類の質問を評価し、コードのポリシーが結果を組み合わせる関係を表しています。公式ロゴ・製品画面・内部ニューラルネットワークの構造図や、実測した確率のグラフではありません。
1. Jevの役割:文章を作る代わりに判断を返します
入力は状態、出力は限定された答えです
一般的なチャットボットには「この問い合わせをどう処理すればよいですか?」と尋ねます。Jevには、処理に必要な状態と判定基準を一緒に渡します。
たとえば、ゲームの不具合報告を次のように分けます。
state:報告内容、実行環境、関連ログなど、判断に必要な資料questions:「担当領域はどこか?」「問題の深刻度はどの段階か?」「再現手順が記載されているか?」criteria:選択可能な領域と、深刻度の各段階の定義
3つの要素の中で決め手となるのがcriteriaです。「適切に処理しておいて」という指示ではなく、アプリケーションが受け取れる答えの範囲と意味を先に定義します。 Jevの結果を読んだコードが、レビュー待ちキューや担当チームを選びます。実際のチケット作成や権限変更は、別の実行コードの役割です。
TypeSafeは、このようなモデルをSystem Oneと呼んでいます。自然言語の入力を理解する一方、自由形式の回答・コード・判断理由を生成せず、型が定まった判断と確率を返すという区別です。現在のJevの入力はテキストで、文字列、JSONオブジェクト、テキスト配列をサポートしています。画像・音声・動画は直接入力できません。System Oneの公式説明
System Oneという名前は、速く直感的な判断を意味する心理学のSystem 1に由来します。モデルの内部に、人間の直感と同じ思考体系が実装されているという意味ではありません。
3種類の質問タイプ
| タイプ | 任せる判断 | 戻り値の意味 |
|---|---|---|
| Choice | 決められた候補のうち、どれか? | 選択された候補、候補ごとの確率、confidence |
| Score | 説明で定義された段階のうち、どの程度か? | 段階ごとの確率の加重平均、分布、confidence |
| Noul | 命題は真か? | 真である確率を表す0~1の実数 |
NoulをBooleanとして読むと、重要な情報が失われます。0.51と0.99はどちらもtrue寄りですが、自動処理のポリシーで同じように扱う理由はありません。一方、Scoreの1.4は「真である確率140%」ではなく、複数の段階にまたがる分布の平均です。Choice、Score、Noul
Choiceの候補はリクエストごとに変更できます。一度学習した固定ラベルだけを出力する業務専用の分類APIとは、インターフェースが異なります。候補名と説明に意味を持たせる必要があり、応答の対応付けに使う質問IDはモデルの判断入力には使われません。is_dangerousというIDを付けるだけで、質問本文から危険の基準を省いては不十分です。Primitivesドキュメント
2. Transformerとは何が違うのでしょうか?
まず比較するレイヤーを揃える必要があります
Transformerはニューラルネットワークのアーキテクチャであり、Jevは特定の学習目標と判断インターフェースを持つモデルです。 したがって、「Transformer対Jev」を、互いに置き換え可能な2種類のニューラルネットワーク構造のように比較するのは正確ではありません。
区別すべきレイヤーは次のとおりです。
| レイヤー | 問うこと | 例 |
|---|---|---|
| ニューラルネットワークの構造 | 入力間の情報を、どの演算で結合するか? | Transformerのattentionと階層構造 |
| 推論・出力方式 | どのような依存関係で答えを作るか? | 自己回帰によるトークン生成、分類値の評価 |
| 学習目標 | どのような結果をうまく出せるように学習したか? | 次のトークンの予測、選好の最適化、判断と確率の較正 |
| 製品インターフェース | 呼び出すプログラムが何を渡し、何を受け取るか? | 会話メッセージとテキスト、stateとtyped answers |
速度に直結する比較は、主に2番目のレイヤーです。同じTransformer系でも、長いテキストを逐次生成する経路と決められた候補の判断値を得る経路では、行っている処理が異なります。
Transformerの原論文は、recurrenceを使わず、attentionを中心に情報を処理する構造を提案しました。だからといって、Transformerで作られたすべてのモデルが文章を1トークンずつ生成するわけではありません。BERTは、双方向Transformerの表現に出力層を付け、言語推論などのタスクを処理した代表的な例です。Transformerと自己回帰によるテキスト生成は同義ではありません。 Attention Is All You Need、BERTの原論文
Jevの内部ニューラルネットワークは、どこまで公開されているのでしょうか?
TypeSafeは、事前学習済みの言語モデルを判断モデルとして学習させるRLCDの手法を説明しています。ただし、確認した公開資料には、基盤モデル名、パラメータ数、attentionの配置、レイヤー数、出力ヘッドの具体的な構造は記載されていません。TypeSafe AI primer
したがって、次の2つの説明は区別する必要があります。
確認できる説明:Jevは、一般的な自由テキストの自己回帰生成の代わりに、構造化された判断と確率を返すように設計されています。
確認できない説明:JevはTransformerをまったく使わず、特定のサイズの分類ヘッドで行列積を1回だけ計算します。
この記事の処理図とコスト式も、公開されている動作を説明する概念モデルです。非公開のニューラルネットワークを逆算して復元した設計図ではありません。
3. 高速に処理できる理由
3.1 長い出力のトークン依存性を避けます
GPT系の自己回帰言語モデルが回答\(y_1,\ldots,y_N\)を生成する際の確率は、次のように表せます。
\[P(y\mid x)=\prod_{t=1}^{N}P(y_t\mid x,y_{<t})\]後続のトークンは、それまでに実際に選択されたトークンに依存します。入力を処理するprefillの後も、回答のトークンを作るdecodeが続く理由です。Transformer内部の行列演算を並列化することと、まだ決まっていない将来の出力まで一度に確定することは、別の問題です。
KV cacheは、処理済みトークンのkeyとvalueを再利用して重複計算を減らします。しかし、次のトークンがそれ以前の出力に依存する関係までなくすわけではありません。「キャッシュがあるので長い回答も一度に生成される」という説明は誤りです。Hugging FaceによるKV cacheの説明
不具合報告を分類するために、次のような回答を最後まで待つ必要はありません。
1
2
3
報告内容を検討した結果、この問題はレンダリングよりもクラッシュの不具合に該当します。
深刻度は高く、ユーザーが繰り返し発生する手順を書いているため、再現情報があります。
したがって、担当チームに送るのがよいと考えられます。
プログラムに必要なのは、担当領域・深刻度・再現情報だけです。Jevは説明文の代わりに、定義された型の答えを返します。答えや確率をトークンごとに書き連ねる経路を避けることが、最初の高速化要因です。Jev発表の並列サンプリングの説明
もちろん、HTTP応答にはJSONの文字列や数値が含まれます。「テキストを生成しない」という説明は、自由テキスト生成モデルのように答えを書かないという意味であり、ネットワーク応答に文字や出力バイトが存在しないという意味ではありません。
3.2 同じ状態に対する複数の質問を並列評価します
1件の不具合報告について、担当領域・深刻度・再現情報をすべて判断したいとします。3つの質問が最初から同じ報告内容だけで答えられるなら、最初の答えを待ってから2つ目の質問を送る理由はありません。
上の図の違いは、質問間に結果の依存関係がないという条件で成立します。通常のLLM呼び出しも、アプリケーション側で並列実行できます。Jevのインターフェースは、1つのstateと複数のtyped questionを1回のリクエストにまとめ、質問を並列かつ個別に評価します。互いの答えを読みながら順番に推論する構造ではありません。複数質問の評価方式
たとえば、「ログサーバーから追加の記録を取得してから原因を判定する」作業は、1回では終わりません。追加ログが届くまで、2つ目の判定の入力は存在しません。必要な依存関係のある作業まで無理に並列化すると、処理速度より先に正確性が崩れます。
TypeSafeが説明するspeculative fan-outは、実行可能な複数の分岐に対応する狭い質問を先にまとめて評価し、後からコードが必要な結果だけを使うパターンです。分類結果を受けてから質問を作る往復を減らせますが、使わなかった質問にも計算コストと入力コストがかかります。Speculative fan-out
3.3 状態の繰り返し送信と呼び出しの往復を減らします
同じ長いログを複数のリクエストにそれぞれ含めると、ネットワークの往復と入力コストが繰り返し発生します。Jevの公式ドキュメントでは、1回のリクエストのstateを一度受け取り、すべての質問で共有すると説明しています。質問を追加すると、その質問の入力トークンは増えますが、同じリクエスト内のstateを質問数の分だけ再び課金する構造ではありません。モデルのcontextとstateの処理
レイテンシを比較するときは、概念的に次の項目を分けると理解しやすくなります。
\[T_{\text{AR}}\approx T_{\text{network}}+T_{\text{prefill}}(L) +\sum_{t=1}^{N}T_{\text{decode}}(L+t)+T_{\text{parse}}\] \[T_{\text{decision}}\approx T_{\text{network}}+T_{\text{state}}(L) +T_{\text{evaluate}}(Q,K)+T_{\text{serialize}}\]ここで\(L\)は入力長、\(N\)は生成トークン数、\(Q\)は質問数、\(K\)は候補・段階の構成に応じた処理量を表します。Jevの実装の正確な実行時間を表す公式ではなく、生成トークンの反復コストと判断処理のコストを区別するための分析式です。キューでの待機・再試行・ツールの実行時間は、別途加える必要があります。
重要なのは、2つ目の式にも\(T_{\text{state}}\)と\(T_{\text{evaluate}}\)が残ることです。入力の意味を処理する計算は必要であり、長いstateや複雑な質問のコストはなくなりません。「質問を無限に追加してもレイテンシは一定」「GPUで計算しない」という結論にはなりません。
3.4 JSONモードだけでも同じ効果が得られませんか?
自由文の代わりにJSONで応答させれば、不要な説明を減らせます。スキーマを強制するconstrained decodingも、不正な構造を制限します。ただし、出力形式の制限と、トークンの逐次生成をなくすことは別々の最適化です。自己回帰モデルがJSONを書くなら、そのJSONも出力トークンです。
一方、既存の言語モデルから短いラベルや候補ごとのlogitsだけを読み、高速に分類する構成も可能です。BERT系の分類器も、長い文章の生成を必要としません。Jevの違いは「ほかのすべてのモデルは、遅い文章生成を必ず行う」ということではありません。リクエストごとに定義する判断基準、確率を扱う学習目標、複数質問の並列インターフェースを1つのサービスとして提供する点にあります。
出力が1トークンの分類器と長文のreasoningモデルを比較し、モデル名だけで速度の優位性を一般化してはいけません。モデルサイズ・出力長・推論設定・ネットワーク条件まで揃えて初めて、どのコストを減らしたのかが分かります。
4. RLCDは何を学習させるのでしょうか?
RLCDはReinforcement Learning for Calibrated Decisionsの略です。TypeSafeは、事前学習済みの言語モデルを、人に見せる回答ではなく、ソフトウェアが使う判断と較正された確率を返すように学習させるアプローチだと説明しています。RLCDの公式概要
学習目標を分けると、違いが明確になります。RLHFは人間の選好フィードバックを使い、RLVRは正解かどうかのような検証可能な報酬を使います。RLCDが重視する目標は、どの判断が正しいか、そしてその判断に付けた確率が実際の結果をどれほどよく反映するかです。3つのアプローチを、必ずしも互いに排他的なニューラルネットワーク構造として理解する必要はありません。
たとえば、答えは合っていても根拠が乏しい状況で毎回確率0.99を返すモデルは、自動化には危険です。逆に、毎回0.50を返しても、レビューが必要な事例を区別しにくくなります。よい判断インターフェースには、結果を区別する能力だけでなく、不確実性を活用できる数値として伝える能力が必要です。
これをcalibration、確率の較正と呼びます。0.8と予測した事例を十分に集めたとき、実際の事象が約80%で発生する関係です。個々のリクエストの答えが必ず正しいという保証ではなく、予測の集団に対する性質です。System Oneのcalibrationの説明
公開資料には、RLCDの具体的な損失関数、報酬の計算式、学習データの構成や規模は記載されていません。そのため、「この式でBrier scoreを最小化する」「RLCDを適用するだけで確率が常に正確になる」と断定する根拠はありません。公開されている学習目標と、実際の製品で検証すべき確率の品質を区別する必要があります。
5. probabilityとconfidenceを混同してはいけません
Choice:選択確率と分布の確信度
Choiceの選択肢は、確率分布を持ちます。開発者は最も確率の高い選択肢だけを読むことも、候補間の分布全体をポリシーに使うこともできます。
公式のChoice confidenceは、選択肢の数\(n>1\)に対して次のように計算します。
\[c=\frac{p_{\max}-1/n}{1-1/n}\]3つの候補の分布を(0.6, 0.3, 0.1)と仮定すると、次のようになります。
最も高い選択確率は0.6ですが、confidenceは0.4です。均等分布と比べてどれだけ1つの候補に確率が集中しているかを正規化した値なので、confidenceの0.9を正答率90%と読んではいけません。 候補数が変わると、同じ最高確率でもconfidenceは変わります。Confidenceの定義
確信に満ちた分布でも、誤ることはあります。モデルのバージョン・候補の構成・ドメインが変わったら、従来のしきい値をそのまま維持せず、自動処理した集団の実際の誤り率を再確認する必要があります。
Score:段階の分布の平均です
Scoreのcriteriaは、低い段階から高い段階へ並べた説明の配列です。3段階を定義するとインデックスは0, 1, 2となり、返されるscoreは次のとおりです。
たとえば、段階の確率を(0.1, 0.4, 0.5)と仮定すると、scoreは1.4です。0~1に自動で正規化された数値ではなく、「実際の障害時間は1.4時間」のような、正確な連続測定値を推定した結果でもありません。Scoreの戻り値
Score confidenceは、最頻の段階から分布がどれだけ広がっているかを要約します。Choiceの式をそのまま適用するわけではありません。段階の説明も「前の段階より深刻」のように隣の説明を参照するのではなく、各段階がどのような状態を意味するのかを独立して書く必要があります。
Noul:確率をポリシーに変える責任はコードにあります
Noulの.noulは、命題が真である確率です。別の.confidenceフィールドはありません。たとえば「再現手順は十分か?」という質問から得た確率を使い、自動転送 / 追加情報の依頼 / 人によるレビューという3つのポリシーに分けられます。Noulの公式ドキュメント
ただし、境界を0.5にするか0.9にするかを、モデルが代わりに決めてくれるわけではありません。誤って自動処理するコストと、人がレビューするコストは異なるためです。特に決済・アカウントの初期化・ファイル削除のような操作の権限と明示的な承認は、モデルの確率とは別に検査する必要があります。 モデルが「安全である確率が高い」と答えることと、ユーザーがその実行を許可したことは別の事実です。
6. SDKを見ると役割分担がより明確になります
ゲームの不具合報告を3つの質問に分ける例
公式Pythonパッケージはtypesafe-sdk、import名はtypesafe_sdkです。以下はPython SDK 0.7.2の呼び出し形式に合わせて書いた例です。TYPESAFE_API_KEY環境変数にキーを設定する必要があり、実行すると外部APIの呼び出しと料金が発生します。記事の作成中に実際の呼び出しや結果の取得は行っていません。韓国語の運用データを評価する例として、コード内の入力と判定基準は韓国語のまま残しています。公式Python SDK
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

state = {
  "report": (
    "전투가 끝나고 결과 화면으로 넘어갈 때 앱이 종료됩니다. "
    "같은 맵에서 전투를 다시 끝내면 똑같이 발생합니다. "
    "재접속하면 전투 기록은 남아 있습니다."
  ),
  "environment": {"platform": "Android", "build": "test-build"},
}

with TypeSafeClient() as client:
  result = client.system_one(
    model="jev-1.13.0",
    state=state,
    questions={
      "area": Choice(
        instructions="report에서 설명한 주된 문제 유형은 무엇인가?",
        criteria={
          "crash": "앱이 비정상적으로 종료되거나 응답하지 않는다.",
          "rendering": "앱은 동작하지만 화면의 표시나 시각 효과가 잘못된다.",
          "network": "서버 연결이나 통신 오류가 주된 문제이다.",
          "other": "위 유형에 해당하지 않거나 분류에 필요한 정보가 부족하다.",
        },
      ),
      "severity": Score(
        instructions="report에 적힌 증상을 플레이 방해 정도로 평가하라.",
        criteria=[
          "표시상의 문제이며 플레이 진행을 막지 않는다.",
          "일부 기능을 방해하지만 앱을 종료하지 않고 진행할 수 있다.",
          "앱 종료 또는 진행 불가로 플레이를 중단시킨다.",
        ],
      ),
      "has_steps": Noul(
        instructions="report에 문제가 발생하는 행동 순서가 적혀 있는가?",
        criteria={
          "true": "문제 발생 전 사용자가 수행한 행동이나 전환 순서를 설명한다.",
          "false": "증상만 설명하고 발생 전 행동 순서는 설명하지 않는다.",
        },
      ),
    },
  )

area = result.choices["area"]
severity = result.scores["severity"]
steps_probability = result.nouls["has_steps"].noul

# 説明用のしきい値です。実際の韓国語の報告データで評価した後に調整する必要があります。
if area.choice == "other" or area.confidence < 0.8:
  queue = "human_review"
elif steps_probability < 0.8:
  queue = "request_reproduction_details"
else:
  queue = f"qa_{area.choice}"

print(result.model, queue, severity.score)
この例でJevが行うのは、同じ報告内容に対する3つの判断までです。queueはコードが選んだ文字列であり、チケットを作成したという実行結果ではありません。報告内容とポリシーの境界は例のために作成したもので、実際の分類確率・応答時間・出力値を捏造したものではありません。
has_stepsも「手順が記載されているか」だけを尋ねます。実際の端末で手順を実行して再現に成功したかまで保証するものではありません。より強い結論が必要なら、ログの確認やテストの実行という観測段階を追加する必要があります。
呼び出しインターフェースで注意する点
Choiceのcriteriaは候補名をキーに持つオブジェクトで、Scoreは順序のある説明の配列です。Pythonでは、応答をresult.choices、result.scores、result.noulsに分けて読めます。応答JSONを受け取り、eval()でコードのように実行する処理は不要です。Pythonの質問型、Pythonの応答実装
HTTPで直接呼び出す場合は、POST https://api.typesafe.ai/v1/systemoneにstate、model、questionsを送ります。JavaScriptの公式SDKは@typesafe-ai/sdkで、メソッド名はsystemOneです。Pythonのsystem_oneとは名前が異なります。HTTP API、公式JavaScript SDK
Vercel AI Gatewayを使う場合も、通常のテキスト生成APIと区別する必要があります。確認日時点で、TypeScript AI SDK 7.0.128以上はexperimental_decideとgateway.decisionModel('typesafe-ai/jev')を使います。以前の名前のexperimental_evaluateと混同しやすく、HTTPパスはまだ/v1/evaluateです。API名が変わる初期段階の製品なので、古い例をそのままコピーするより、使用中のバージョンの公式ドキュメントを確認する必要があります。Gateway Decision API
7. 実際にはどこで使われるのでしょうか?
Jevが効果を発揮するのは、多くの場合、生成とツール実行の間にある狭い判断箇所です。公開プロジェクトを見ると、モデル自体の役割と、その周囲のコードの役割を区別できます。
モデルのルーティングとツール実行前の評価
LangChainのModelRouterMiddlewareは、ユーザーメッセージをあらかじめ定義した基準で分類し、使う生成モデルを選びます。Jevが回答を書くのではなく、どのモデルに回答を任せるかを選びます。同じ統合のAutoModeMiddlewareは、登録されたツール呼び出しを評価し、危険だと判断すると、実行の代わりにエラーメッセージを返します。人の承認を得る手順自体は、別途実装する必要があります。LangChainのTypeSafe統合
実行の境界は、次のように分けると明確になります。
上の図から権限検査が抜けると、モデルの高い確率が実行許可のように扱われます。Jevは意味の判定を助けるコンポーネントであり、権限システムではありません。 入力データに隠れた悪意のある指示もモデルの判断を揺さぶり得るため、typed outputだけでは安全性は完成しません。
ブラウザー操作:行動候補を選び、実行側が確認します
browser-use/jev-ultrafastは、観測したDOM要素に番号を付け、1回のリクエストに操作の種類と、操作ごとの対象を問う質問を含めます。クリックが選択されたら、クリック対象の答えを使います。テキスト入力が必要な場合は、別の小さなLLMが入力文字列を作ります。Jevがスクリーンショットを見て座標やJavaScriptを自由に生成する構成ではありません。プロジェクトのREADME、リクエスト構成の原本
公開された性能ドキュメントでは、1つのGoogle Flightsのタスクで各バージョンを3回ずつ比較したと説明しています。高速なデモがあることは確認できますが、すべてのサイトの操作を同じ速度と成功率で処理する証拠ではありません。観測したノードがまだ有効か、クリックできるかも、周囲の実行コードで検査します。測定範囲と制約
コンテキスト圧縮:新しい要約文の作成ではなく、保持するかの判断です
コミュニティプラグインのfast-jev-compactionは、ツールの呼び出しと結果をまとめ、それぞれを残す必要があるかをNoulで評価します。コードが、原文の保持・結果の短縮・削除を選びます。Jevが新しい要約文を書く方式ではありません。 プラグインの原本、圧縮の分岐実装
注意点は、判断用のstateにツール結果の本文全体が含まれていないことです。結果の長さ・成功したかどうかといった情報と、会話・呼び出し内容を使います。そのため、「内容全体を読んで重要な事実だけを完全に保持する」と紹介するのは誤りです。残した原文を書き換えないことと、圧縮全体が無損失であることは別です。state構成の原本
ゲームではフレーム処理よりも上位の意思決定に近い位置付けです
TypeSafeのDoomの例は、画像ではなく、構造化されたテキストのゲーム状態を使います。ルールベースのボットよりうまくプレイするという主張でもありません。Doomの例の条件
ゲーム開発に適用するなら、NPCの上位行動候補の評価や、運用上の報告の分類がまず思い浮かびます。ただし、これは適用可能性についての設計上の解釈であり、このブログのゲームプロジェクトにJevをすでに組み込んだ使用記ではありません。衝突処理・クールダウン・ダメージ計算・フレームごとの移動など、コードで正確に計算できる処理を外部モデルに移す理由はありません。数百msの応答でも、60fpsにおける1フレームの予算、約16.7msとは異なる時間スケールです。
8. ベンチマーク:何が測定され、何がまだ分からないのでしょうか?
会社が示す193.6倍・444.6倍という数値
TypeSafeの発表記事は、193.6倍高速で、444.6倍低コストという数値を示しています。会社が構成した4つのworkflow評価の結果であり、すべてのタスクに対する保証やSLAではありません。ほかのLLMもwrapperを介して確率を出力するように接続しています。基準となる応答は、人間の正解ラベルではなく、GPT-6 AstraとClaude Fable 5.1の平均です。会社は、評価の偏りや、実際の環境で利点が小さくなる可能性も説明しています。会社の評価条件、公開されたworkflow評価
1つの判断ラベルだけが必要なサービスと、複数候補の確率を生成する比較用サービスでは、出力量が異なります。そのため、数値を引用する際は、同じ最終業務をどのような呼び出し・出力方式で行ったかまで読む必要があります。
同じ発表の「ハルシネーション0」は、スキーマへの適合保証から算定した値であり、意味の判定が無誤りだったという実測値ではありません。crashという有効なラベルでネットワークの問題を誤分類することは、依然としてあり得ます。型の保証とグラフの算定条件
外部評価で確認された低レイテンシと低コスト
9月29日に公開されたEvaluating and Benchmarking the System One Model Jevは、jev-1.13.0を37のデータセットで評価しました。本評価の346,009リクエストの費用は9.15ドル、平均client-sideレイテンシは0.36秒でした。同時リクエスト32件とネットワーク時間を含む測定です。比較対象のオープンウェイトモデルは、reasoningなしで候補のlogitsを読む方式でした。論文§4.7・§5
この測定は、短い判断タスクで低い費用とレイテンシが得られる根拠です。会社の193.6倍という数値を、同じ条件で独立に再現したという意味ではありません。GPU内部の推論時間、韓国から呼び出したときのレイテンシ、長期運用のP95に代わる値でもありません。
確率はタスクごとに検証する必要があります
同じ論文では、Choiceの統合ECEは0.028ですが、multi-label NoulのECEは0.168でした。ECEは、予測確率と、その事象の実際の発生頻度との差を区間ごとに要約する指標です。Choiceでは選択候補が正解である頻度、Noulでは実際のyesの発生頻度と比較します。異なるタスク・集計条件の数値を、1つの「信頼度」にまとめてはいけません。UNFAIR-ToSのmicro-F1も、固定の0.5しきい値では0.499、学習データで調整したしきい値では0.748でした。論文§4.3
9月28日に公開された別のSys1Cal-v1研究では、正解の確率が既知の92の合成問題を365通りの形で表現しています。同じ命題でも、Choice・Noul・Scoreや文章の表現によって、確率が一貫しない場合があると報告しています。論文の0.978という数値は、一般的な正答率97.8%ではなく、不確実性を含む区間と正解確率の適合性指標です。Sys1Cal-v1論文
2つの外部研究はまだpreprintで、評価の目的も異なります。最初の研究の一般的な分類性能と、2つ目の研究の合成確率問題を、単純な賛否の結果としてまとめることはできません。実務で必要な結論は、「確率が出るので、すぐに安全に実行できる」ではなく、自分のタスクで確率・しきい値・レビューのポリシーを一緒に評価することです。
9. Jev 1.13で残しておくべき境界
製品自身が公開している弱点
TypeSafeの10月2日レビューのドキュメントは、次の弱点を明記しています。
- 数学・個数の集計・正確な数値比較と日付比較
- 二重否定や、複数の段階を経る間接的な判断
- 判断と無関係な内容を多く含む長いstate
- 悪意のある指示を含む入力、矛盾したinstructionsとcriteria
- Choiceの候補順序による応答の変化
- 自由テキストの生成タスク
最も直接的な設計原則は、意味の判断だけをモデルに任せ、正確な演算はコードに残すことです。「危険なリクエストに見えるか?」と「取引金額が上限を超えているか?」を、1つのモデルへの質問にまとめません。後者は、すでに得られた数値で比較できます。質問が独立して評価されるという性質も、無関係な長いstateの影響を受けないという意味ではありません。Jev 1.13の公式known issues
現在のモデルの入力と料金の制約
| 項目 | 2026-10-06の公式ドキュメント基準 |
|---|---|
| バージョン | jev-1.13.0;jev-latestとjev-previewも現在は同じバージョン |
| 入力 | テキストのみ対応 |
| リクエストのcontext | stateとすべての質問の合計で64k tokens |
| 個別質問のcontext | stateと最も長い質問の合計で32k tokens |
| 料金 | 入力100万トークンあたり$0.042、出力は無料 |
| 明記された処理上限 | 1秒あたり100K tokens / 80 requests;変更される可能性あり |
出力無料は料金ポリシーです。出力の計算が物理的に無料という意味ではありません。また、contextの最大値に収まることは、その最大長での正確性を保証しません。英語が主な学習言語で、最も正確だと明記されているため、韓国語の運用データでは別途検証する必要があります。現在のモデルカード
jev-latestは、新しいモデルが登場すると参照するバージョンが変わります。しきい値を評価済みの製品では、バージョンIDを固定し、応答のモデルバージョンを記録するほうがよいでしょう。料金・上限・SDK APIも時間とともに変わるため、この記事の数値を恒久的な仕様として読んではいけません。
導入前にはモデルだけでなく、経路全体を測定します
実際のサービスのレイテンシには、モデルの応答時間に加え、状態の収集、ネットワーク、再試行、追加情報の取得、fallbackの時間がかかります。SDKのbackoffと再試行は一部のリクエストのレイテンシを増やすため、成功した単一呼び出しの平均だけでなく、経路全体のP95も別途測定する必要があります。データの送信範囲も重要です。顧客データで学習しないという説明と、保存やログを一切残さないという保証は同じではありません。契約と保存ポリシーを別に確認する必要があります。APIのエラーと再試行、モデルのデータ処理の説明
少なくとも次の項目を、独自評価に含めるのがよいでしょう。
- 実際の韓国語の事例と境界事例に対する分類誤り・確率の較正
- しきい値ごとの自動処理率と、自動処理された事例の誤り率
- 候補順序を変えた入力、否定文、入力内の悪意のある指示
- workflow全体のP50・P95と、再試行・fallbackを含む費用
- timeout・rate limit・判定の衝突時に保守的にレビューへ回す経路
この中の2番目が、自動化の水準を決めます。しきい値を上げて誤りを減らしても、ほとんどの事例が人に回るなら、業務への効果は変わります。誤り率と自動処理率を一緒に見ることで初めて、高速なモデルが製品全体をどれほど速くしたのかを判断できます。
まとめ:生成と判断を分けて捉えます
Jevを理解するうえで最も重要な比較対象は、Transformerそのものよりも、文章生成器で小さな判断を行っていた処理経路です。自然言語で定義された基準を読みながら、出力空間を判断の型に限定し、独立した質問をまとめ、コードで結果を組み合わせられるように提供するモデルです。
回答の作成・新しいコードの生成・長い推論が必要な場所には、生成モデルが残ります。ルーティング・分類・評価のような狭い判断を繰り返す場所では、判断モデルを検討できます。どのモデルが賢いかだけを問うのではなく、プログラムに必要な結果が文章なのか判断なのかを先に決めることが、Jevを正しく評価する出発点です。
調査範囲と主な原文
公式ドキュメントの概念・質問タイプ・confidence・モデルカード・known issues、Python・JavaScript SDKとadapter、Gateway・LangChainの統合、ブラウザー操作・圧縮プロジェクトの原本、2つの外部評価論文を調べました。内部の重みや学習コードを入手したわけではなく、例のプロジェクトを直接実行したり、有料APIのベンチマークを行ったりもしていません。
| 確認する内容 | 一次資料 |
|---|---|
| 公開の目的・会社の性能に関する主張 | TypeSafeの発表記事 |
| モデルの概念・学習目標 | System One、RLCDの概要 |
| 型・確率・仕様 | Primitives、Confidence、Models |
| SDK・比較用adapter | Python SDK、JavaScript SDK、System One adapter |
| 外部の業務評価 | 37データセットの評価論文 |
| 外部の確率の意味に関する評価 | Sys1Cal-v1論文 |
比較用adapterは、ほかのLLMを同じ質問・応答インターフェースにつなぐツールです。Jevの重みを提供したり、RLCDと確率の較正を再現したりする公開モデル実装ではありません。同じAPIの形と、同じモデルの動作を混同してはいけません。